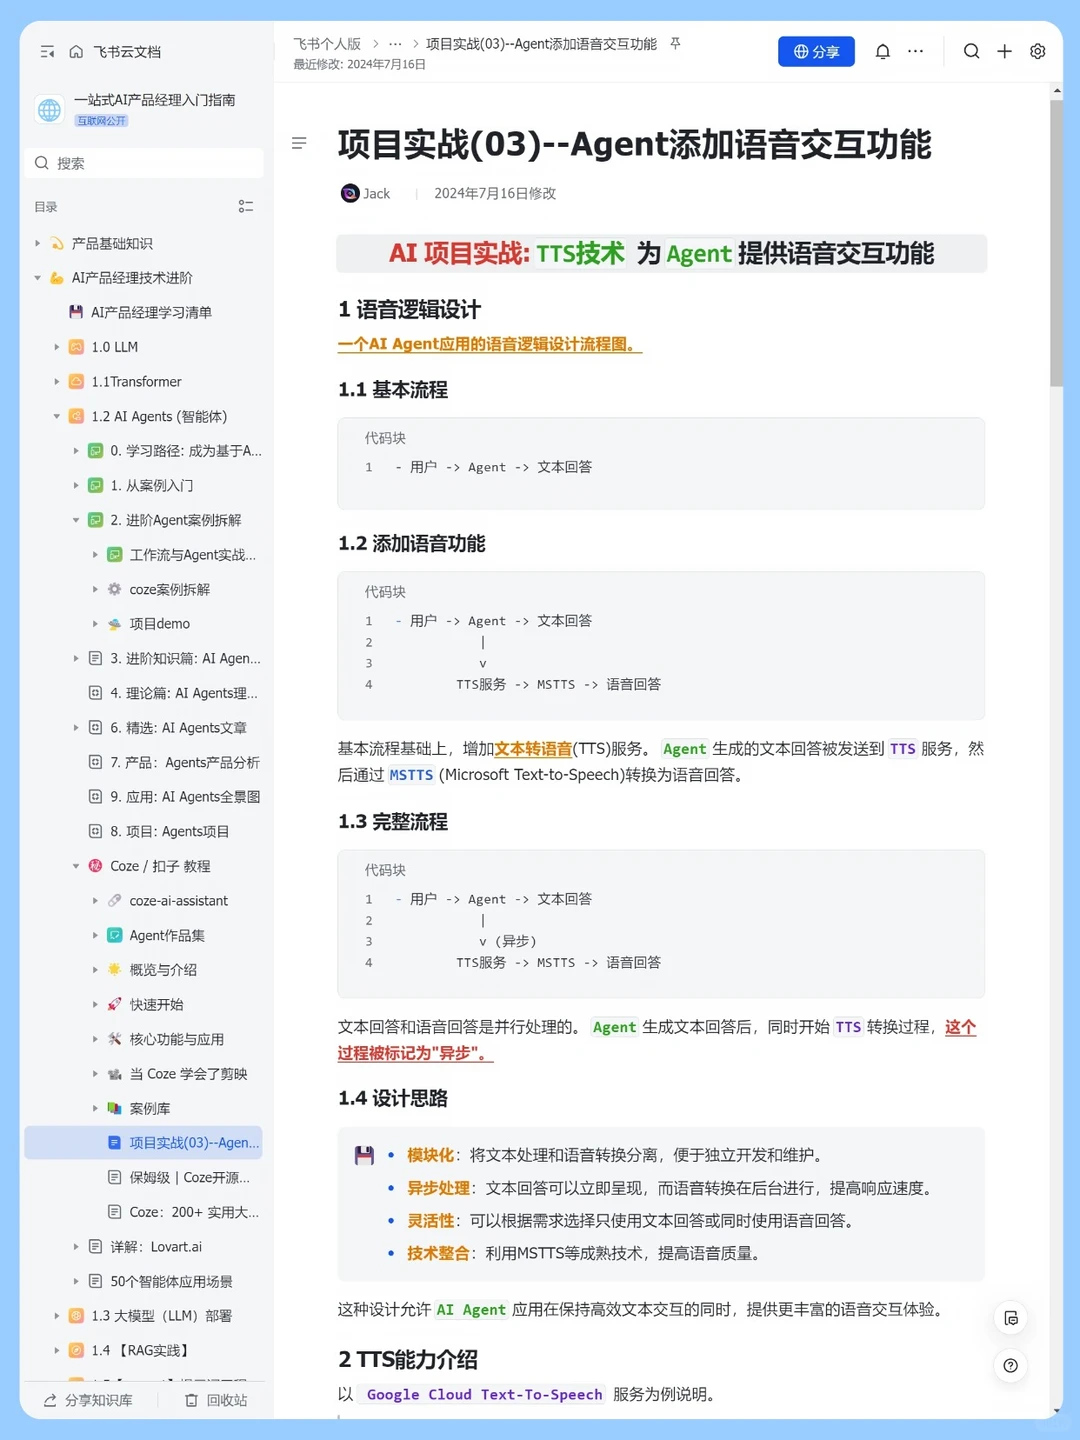
项目实战(03)--Agent添加语音交互功能
项目demo · 在文字回答基础上增加TTS
AI项目实战:TTS技术为Agent提供语音交互功能
先保留可阅读的文字结果,再把同一段文字交给语音服务。语音失败时,文字仍然可以使用。
1 语音逻辑设计
1.1 基本流程
text
用户 → Agent → 文本回答1.2 添加语音功能
text
用户 → Agent → 文本回答
                 ↓
TTS服务 → MSTTS → 语音回答在基本流程基础上,增加文本转语音(TTS)服务。Agent 生成的文本回答发送到 TTS 服务,然后由语音合成服务转换为语音回答。原图使用 MSTTS 作为其中一个服务名称。
1.3 完整流程
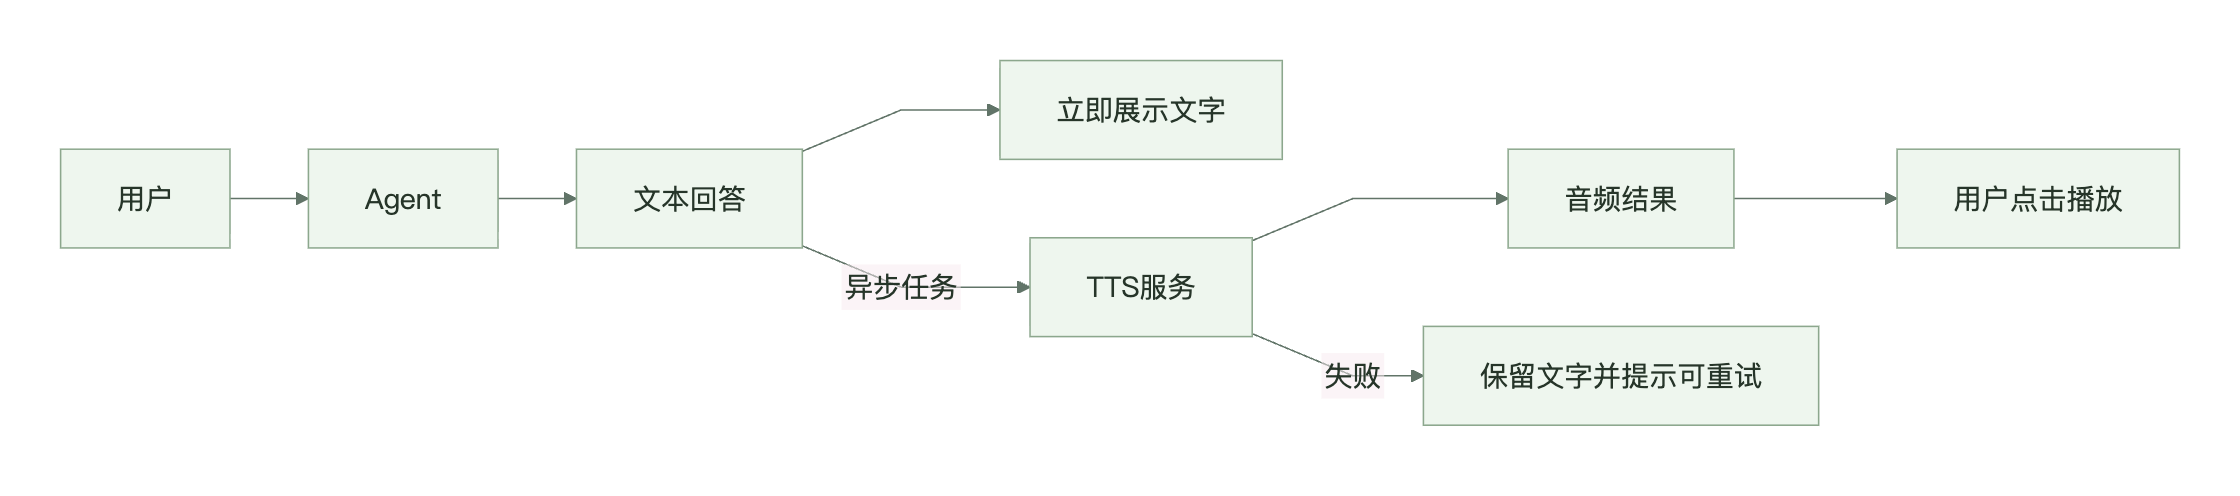
文本显示与语音合成可以并行处理:文本生成后立即显示,同时启动 TTS 任务。语音合成结束后更新播放状态,不必阻塞文字展示。
1.4 设计思路
四个设计重点
- 模块化: 将文本处理和语音转换分离,便于独立开发和维护。
- 异步处理: 文本回答立即呈现,语音转换在后台进行。
- 灵活性: 根据需要选择只使用文本,或同时提供语音。
- 技术整合: 通过统一接口连接所选 TTS 服务,按音色、语言和质量验收。
2 TTS能力介绍
参考图在这里开始介绍 Google Cloud Text-to-Speech。不同服务在支持语言、音色、编码格式和流式方式上有所差异;本页以统一任务契约说明接入方法,具体参数遵循所选服务的当前文档。
| 字段 | 含义 | 检查点 |
|---|---|---|
| text | 已确认的回答文本 | 不合成尚未确定的内容 |
| language | 目标语言 | 与文本语言一致 |
| voice | 服务支持的音色 | 由服务返回的可选项决定 |
| request_id | 本轮回答编号 | 防止旧音频覆盖新回答 |
| audio_url | 合成音频位置 | 可访问且未过期 |
3 补写实践:异步任务与页面状态
python
import asyncio

async def reply_with_audio(text, synthesize, publish):
    # synthesize和publish是调用方提供的异步函数。
    await publish({"type": "text", "text": text})
    await publish({"type": "audio_status", "status": "loading"})
    try:
        audio = await asyncio.wait_for(synthesize(text), timeout=30)
    except (TimeoutError, OSError):
        await publish({"type": "audio_status", "status": "failed"})
        return
await publish({"type": "audio", "audio_url": audio})这是调度示意,尚未接入具体服务。页面应有未开始、合成中、可播放、失败四种状态。用户切换会话或重新提问时,按 request_id 忽略过期结果。
4 分段播放、打断与验收
长回答可按完整句子分段合成,再按顺序播放。用户按停止按钮后,立即停止当前播放并清空待播队列。若任务已经发往服务端,可取消则取消,不能取消则忽略返回。
测试四件事: 文字先出现;音频内容与文字一致;合成失败不影响文字;第二个回答不会播放第一个回答的音频。浏览器播放可能需要用户点击,界面应提供明确的播放按钮。
内容依据:用户提供的第 16 张参考图。保留其可见结构、概念和案例,截图未显示的步骤为教学补写。原图作者与历史标注见下方对照。
查看参考原图 · 完整保留截图中的图表与可见文字